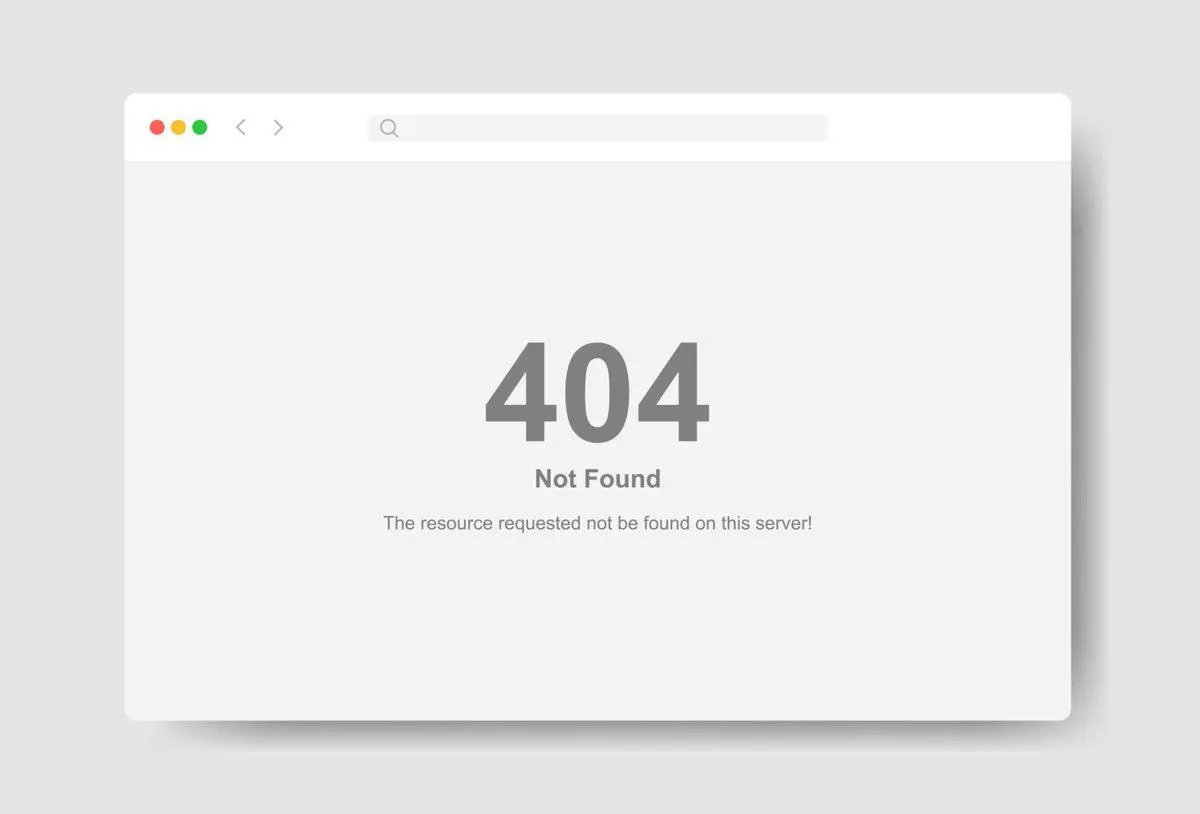
Die Zahl 404 im im Internet häufig anzutreffenden Fehlercode "404 Not Found" ist keine zufällig gewählte Ziffer; sie ist Teil der 4xx-Gruppe des HTTP-Protokolls, die Client-Fehler klassifiziert. Entgegen der verbreiteten CERN-Raum-Legende entstand der Code als standardmäßig definierter Statuscode für die Antwort "Not Found" in den HTTP-Standards.
Die Zahl 404 in der Warnung "404 Not Found", mit der Nutzer häufig konfrontiert werden, wenn sie eine nicht existierende Seite im Internet öffnen wollen, ist keine zufällig gewählte Zahl. Laut Quelle entstand dieser Code als Teil der systematischen Statuscode-Struktur des HTTP-Protokolls und wurde im Laufe der Jahre zu einem bekannten Symbol der Internetkultur.
Nutzer begegnen diesem Code in der Regel, wenn sie eine falsch geschriebene Adresse eingeben, auf einen alten Link klicken oder wenn der gewünschte Inhalt gelöscht wurde. Die 404 wurde so verbreitet, dass viele Unternehmen begannen, ihren Fehlerseiten eigene Designs, Spiele und Witze hinzuzufügen.
Was bedeutet 404 Not Found eigentlich?
Wenn eine Internetadresse geöffnet wird, sendet der Browser eine Anfrage über HTTP an den betreffenden Server. Der Server verarbeitet diese Anfrage und gibt eine Antwort mit einem dreistelligen Statuscode an den Browser zurück.
Bei erfolgreichem Abschluss wird in der Regel der Code 200 verwendet. Bei Weiterleitungen oder serverbedingten Problemen können hingegen andere Codes auftreten.
Der Code 404 bezeichnet den Fall, dass der Client den Server erreichen kann, der Server jedoch die angeforderte Ressource nicht findet. Daher sollte man bei einer 404 nicht annehmen, dass die Internetverbindung vollständig unterbrochen ist; der Server hat geantwortet, aber die angeforderte Seite ist unter dieser Adresse nicht vorhanden.
Die Ursache kann eine falsch geschriebene URL sein. Eine zuvor existierende Seite könnte gelöscht, ein Link geändert oder der Inhalt an eine andere Adresse verschoben worden sein.
Was bedeutet die erste 4 in der Zahl 404?
In HTTP-Statuscodes sind die Ziffern nicht willkürlich gewählt; die Codes werden nach ihren ersten Stellen in bestimmte Klassen eingeteilt. Die führende 4 der 404 kennzeichnet die Gruppe der Statuscodes, die mit Client-Fehlern zusammenhängen.
In dieser Gruppe befinden sich auch andere Codes wie 400 Bad Request, 401 Unauthorized, 403 Forbidden und 429 Too Many Requests. Der Unterschied zwischen ihnen ergibt sich aus der Art des Problems.
Beim Code 403 versteht der Server die Anfrage, erlaubt aber möglicherweise keinen Zugriff auf die Ressource. Bei 404 hingegen wurde die angeforderte Ressource nicht gefunden. Der Code 429 wird verwendet, um anzuzeigen, dass innerhalb kurzer Zeit zu viele Anfragen gesendet wurden.
Bei serverbedingten Problemen kommen hingegen Codes ins Spiel, die mit 5 beginnen. 500 Internal Server Error und 503 Service Unavailable sind Beispiele für diese Gruppe.
Somit wird die 404 weniger als eine einzeln gewählte geheimnisvolle Zahl betrachtet, sondern als Teil der systematischen Statuscode-Struktur von HTTP.
Warum wurde nun genau 404 gewählt?
In der Frühzeit von HTTP wurden Statuscodes eingerichtet, um verschiedene Ergebnisse des Protokolls standardisiert ausdrücken zu können. Der Bereich 4xx wurde Fehlerzuständen im Zusammenhang mit dem Client zugeordnet, und innerhalb dieser Gruppe wurden Codes mit unterschiedlichen Bedeutungen definiert.
Laut Quelle wurde 404 im 1996 veröffentlichten RFC-1945-Dokument von HTTP/1.0 ausdrücklich als Statuscode "Not Found" definiert. Auch in späteren HTTP-Standards wurde der Code weiterverwendet.
Für jede Stelle der Zahl 404 gibt es hier keine eigene Bedeutung oder verborgenen Sinn. Die erste Ziffer bestimmt die allgemeine Klasse des Codes, während die übrigen Ziffern den innerhalb dieser Klasse definierten Code angeben.
Eine ähnliche Logik zeigt sich auch bei anderen HTTP-Codes. Erfolgreiche Antworten werden in der Gruppe 2xx, Weiterleitungen in 3xx, Client-Fehler in 4xx und Server-Fehler in 5xx zusammengefasst. Diese Ordnung ermöglicht es Entwicklern, die Antwort des Servers softwaregestützt auszuwerten, ohne sich allein auf den Nachrichtentext verlassen zu müssen.
Ist die Geschichte vom Raum 404 am CERN wahr?
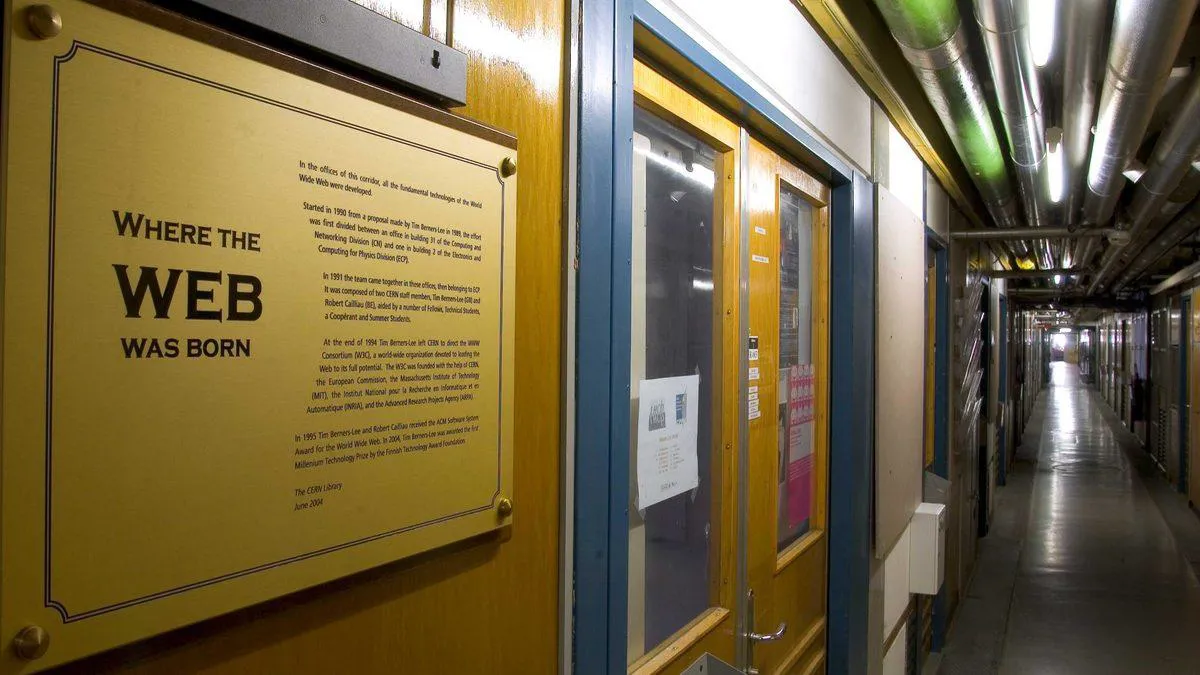
Der im Internet am weitesten verbreiteten Geschichte über die 404 zufolge befand sich das am World Wide Web arbeitende Team am CERN in einem Raum mit der Nummer 404. In verschiedenen Versionen der Erzählung wird behauptet, dass sich die Webserver in diesem Raum befanden oder dass Nutzer sich an diesen Raum wandten, um die gewünschten Dateien zu erhalten.
Laut Quelle gibt es jedoch keine verlässlichen historischen Belege, die diese Behauptung stützen. Auch wenn die Arbeiten von Tim Berners-Lee, der das World Wide Web am CERN entwickelte, im Zentrum der Entstehung von HTTP stehen, ist die Erzählung, dass der Code "404 Not Found" von einem Raum 404 am CERN stammt, durch Quellen zur Webgeschichte nicht bestätigt.
Es wird sogar angegeben, dass in Stellungnahmen des CERN zu dieser Geschichte darauf hingewiesen wurde, dass die Erzählung von besagtem Raum eine Legende sei.
Der Grund für die Verbreitung solcher Geschichten scheint jedoch verständlich. Die Prozesse zur Erstellung technischer Standards mögen für viele Nutzer langweilig wirken, während ein geheimnisvoller Raum und dessen Nummer, die sich im gesamten Internet verbreitet, deutlich einprägsamer sein können.
Wie entstanden die HTTP-Fehlercodes?
Die Geschichte von HTTP reicht bis in die ersten Jahre des World Wide Web zurück. Tim Berners-Lee arbeitete am CERN an einem Informationssystem, bei dem Dokumente auf verschiedenen Computern über Links miteinander verbunden werden konnten.
Damit das Web funktionieren konnte, reichten HTML und URL allein nicht aus; es brauchte auch ein Protokoll, das festlegte, wie Browser und Server miteinander kommunizieren. HTTP übernahm diese Aufgabe.
Die ersten HTTP-Versionen waren viel einfacher als das heutige Protokoll. Mit der Weiterentwicklung des Webs wurde auch die Kommunikation zwischen Browser und Server detaillierter, und es wurde erforderlich, standardisiert auszudrücken, ob eine Anfrage erfolgreich war, an eine andere Adresse weitergeleitet wurde oder fehlgeschlagen ist.
Dank der dreistelligen Struktur konnten Softwareprogramme das Ergebnis schnell interpretieren. Codes, die mit 2 beginnen, standen allgemein für die Klasse erfolgreicher Antworten, solche mit 3 für Weiterleitungen, solche mit 4 für clientbezogene Fehlerzustände und solche mit 5 für Serverfehler.
Dieses System besteht auch heute noch als eines der grundlegenden Elemente des Webs. Die meisten dieser Codes sehen Nutzer nie, weil Browser Vorgänge im Hintergrund ausführen. Die 404 hingegen erlebte ein anderes Schicksal; da sich der Fall, dass die angeforderte Seite nicht gefunden wird, direkt auf den Nutzer auswirkt, entwickelte sie sich von einem technischen Protokollcode zu einem Ausdruck, den jeder kennt.
Warum sehen wir nicht auf jeder gelöschten Seite eine 404?
Wenn eine Internetseite nicht mehr existiert, stößt man nicht immer auf den Code 404. Der Grund dafür ist, dass Websites für verschiedene Situationen andere HTTP-Codes verwenden können.
Wurde ein Inhalt an eine neue Adresse verschoben, kann der Server den Nutzer automatisch auf die neue Seite weiterleiten. Bei dauerhaften Weiterleitungen werden zu diesem Zweck Codes wie 301 verwendet, und da der Browser den Vorgang automatisch ausführt, sieht der Nutzer den Code selbst meist nicht.
Für eine dauerhaft entfernte Ressource kann auch der Code 410 Gone verwendet werden. Der Unterschied zur 404 ist subtil, aber bedeutsam; die 404 gibt an, dass der Server die angeforderte Ressource nicht finden kann, während die 410 deutlicher ausdrückt, dass die Ressource bekanntermaßen entfernt wurde.
In realen Internetseiten wendet nicht jedes System diese Unterscheidung mit derselben Sorgfalt an, und viele gelöschte Inhalte geben direkt eine 404 zurück.
Darüber hinaus gibt es einen Zustand, der als "Soft 404" bezeichnet wird. Während die Seite dem Nutzer die Meldung "Inhalt nicht gefunden" anzeigt, kann der Server technisch die Antwort 200 OK geben. Aus Sicht des Nutzers existiert die Seite nicht, aus HTTP-Sicht erscheint die Anfrage jedoch erfolgreich. Dieser Zustand kann auch die Art und Weise beeinflussen, wie Suchmaschinen die Seite interpretieren.
Das heißt, dass die Anzeige "Seite nicht gefunden" auf dem Bildschirm und die tatsächliche Rückgabe des HTTP-Codes 404 durch den Server nicht immer dasselbe bedeuten.
Wie wurde die 404 Teil der Internetkultur?
HTTP enthält Hunderte verschiedener Statuscodes, doch der durchschnittliche Internetnutzer muss die meisten davon nicht kennen. Die 404 sticht in dieser Hinsicht als große Ausnahme hervor.
Der Hauptgrund dafür ist, dass Nutzer diesem Code direkt und häufig begegnen. Je mehr Internetseiten wachsen, desto häufiger ändern sich Links, alte Inhalte werden entfernt und falsche Adressen geteilt. Infolgedessen werden 404-Seiten zu einem unvermeidlichen Teil der Web-Erfahrung.
Webdesigner begannen mit der Zeit, die Standardfehlermeldung kreativer zu nutzen. Manche Seiten fügten ihren 404-Seiten kleine Spiele hinzu, andere verwendeten humorvolle Bilder, und wieder andere leiteten Besucher über ein Suchfeld oder einen Link zur Startseite zum richtigen Inhalt.
So löste sich der Ausdruck "404" von seiner technischen Bedeutung und wurde in der Internetkultur sogar zu einem Scherz, mit dem Dinge beschrieben werden, die verloren, nicht auffindbar oder nicht vorhanden sind.
Interessant ist, dass hinter dieser so bekannten Zahl kein geheimnisvoller Raum oder eine vergessene CERN-Geschichte steht. Die wahre Geschichte der 404 ist viel technischer; der Code entstand aus dem Bedürfnis des Webs, verschiedene Ergebnisse geordnet und maschinenlesbar zu klassifizieren.